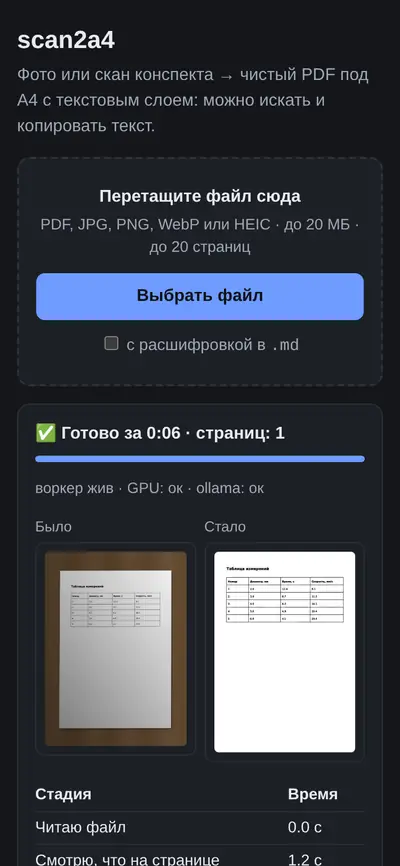
Скан конспекта → PDF с текстовым слоем
Задача
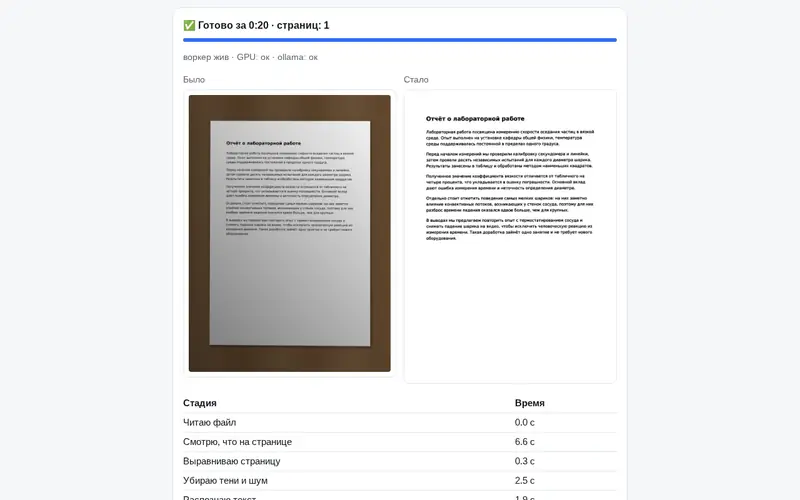
Фото конспекта в телефоне не ищется и не копируется — а сдавать нужно PDF, а не карточку из галереи.
Как
Присылаешь фото или скан (веб или Telegram-бот), классический CV (OpenCV: поиск листа, перспектива, выравнивание, Sauvola-бинаризация) чистит страницу; qwen2.5vl:7b через ollama определяет тип страницы и по желанию делает расшифровку в Markdown, EasyOCR ru+en на GPU кладёт слова с координатами в невидимый слой поверх PDF A4 300 dpi. Каждая стадия и реально отработавший движок показаны в реальном времени; PDF готов до расшифровки. Ничего не уходит сторонним AI-сервисам, копии удаляются через 30 минут после выдачи.
Доказательство
- 338 тестов
- 4 раунда независимого аудита кода Codex: 44 находки, 43 закрыты, 1 принята как риск
- на синтетическом holdout (28 файлов: стол, тени, шум, повороты) — медиана CER 0.2 %, p50 5.6 с/страницу на тёплой модели, 1-битная страница ≤ 96 КБ
собран 2026-09-17Открыть